한 줄씩 쪼개 명령하면 대화가 통째로 다시 계산된다 — LLM을 잘 쓰는 법 (5)
에이전트를 쓰다 보면 어느새 메신저처럼 대하고 있다. "이 버그 좀 고쳐줘" 엔터. "아 그리고 로그도 좀 봐줘" 엔터. "아니 그거 말고 세션 쪽" 엔터. 카카오톡이나 왓츠앱에서 생각나는 대로 한 줄씩 던지던 습관 그대로다. 편하다. 그리고 그 편함은 공짜가 아니다.
이건 매너의 문제가 아니다. 정밀한 요청에 대한 글이 "한 요청을 모호하게 던지는 비용"을 다뤘다면, 이 글은 전혀 다른 축 — "한 작업을 여러 메시지로 쪼개는 비용"을 다룬다. 요청 하나하나가 아무리 명확해도, 쪼개서 보내는 것 자체가 토큰을 샌다. 이유는 LLM이 대화를 기억하는 방식에 있다.
무슨 일이 벌어지나
LLM에는 기억이 없다. 모델은 상태를 갖지 않는다(stateless). 당신이 메시지를 하나 보낼 때마다, 모델은 "지금까지의 대화 전체"를 처음부터 다시 받아 읽는다 — 시스템 프롬프트, 당신의 이전 메시지들, 모델이 했던 이전 답변들, 그 사이 도구가 뱉은 출력들까지 전부. 화면에는 당신이 방금 친 한 줄만 추가된 것처럼 보이지만, 내부에서는 그 한 줄 앞에 붙은 모든 것이 입력 토큰으로 다시 계산된다.
그래서 메시지를 하나 더 보내는 진짜 비용은 "그 메시지의 길이"가 아니다. **"그 메시지 + 그 앞의 모든 맥락"**이다. 대화가 길어질수록 이 꼬리가 무거워진다.
왜 그런가 — 매 턴, 통째로 다시 계산된다
첫째, 고정 오버헤드가 매번 재청구된다. 코딩 에이전트에는 늘 깔려 있는 것들이 있다 — 긴 시스템 프롬프트, 도구 정의, CLAUDE.md 같은 프로젝트 상시 지시. 이것만 수천 토큰이고, 대화 내용과 무관하게 턴마다 빠짐없이 다시 들어간다. 한 작업을 여덟 번에 나눠 말하면, 이 고정 비용을 여덟 번 낸다.
구체적으로 보자. 고정 오버헤드를 5,000토큰이라 하자(실제로는 더 큰 경우도 많다).
- 한 번에 보내면: 1턴. 오버헤드 5,000 + 완성된 요청 400 ≈ 5,400토큰이 한 번 계산된다.
- 쪼개서 보내면: 같은 요청을 50토큰짜리 여덟 줄로. 턴마다 오버헤드가 다시 실려 — 오버헤드만 5,000 × 8 = 40,000토큰. 거기에 앞선 메시지와 답변이 턴마다 누적돼 더 얹힌다.
단순화한 수치지만 방향은 분명하다. 비용을 지배하는 건 당신이 추가로 친 50토큰이 아니라, 그때마다 딸려 가는 수천 토큰의 맥락이다.
둘째, 조각마다 모델이 답한다. 여덟 번에 나눠 말하면 모델은 여덟 번 응답한다 — 그중 상당수는 "네, 확인했습니다" "다음은요?" 같은, 당신이 필요로 하지도 않은 말이다. 출력 토큰은 보통 입력보다 비싸다. 불필요한 응답 여덟 개가 쌓인다.
셋째, 에이전트가 조각마다 방향을 다시 잡는다. 에이전트는 들어온 조각에 반응하려고 파일을 다시 열어 보고, 계획을 다시 세우고, 맥락을 다시 맞춘다. 전체 그림을 한 번에 줬다면 하지 않았을 재작업이 매 조각마다 반복된다. 이 재작업은 다시 토큰이 되어 다음 턴의 꼬리에 또 붙는다.
프롬프트 캐싱은 어디까지 막아주나 (그리고 어디서 깨지나)
여기서 정직해야 한다. 요즘 API에는 프롬프트 캐싱이 있어서, 바뀌지 않은 앞부분(시스템 프롬프트·도구 정의 등)은 캐시에서 싸게(대략 10% 비용) 재사용된다. 즉 턴을 빠르고 연속적으로 이어가면, 위의 "오버헤드 × 8"은 상당 부분 깎인다.
문제는 캐시에 **수명(보통 약 5분)**이 있다는 것이다. 그리고 우리가 메신저처럼 쓸 때의 실제 패턴 — 한 줄 보내고 잠깐 딴 생각하고, 몇 분 뒤 또 한 줄, 중간에 말을 바꾸고 — 이 바로 그 캐시를 가장 자주 깨뜨린다. 5분을 넘기거나 앞 내용을 수정하면, 다음 조각은 전체 맥락을 전액 다시 계산한다. 게다가 캐싱은 재사용되는 입력에만 적용된다. 위의 둘째·셋째 비용 — 조각마다의 출력과 에이전트의 재작업 — 은 캐시로 줄어들지 않는다.
요약하면, 캐싱은 "빠르고 끊김 없는 연속 대화"를 구원하지, "띄엄띄엄 생각나는 대로 던지는 분할 명령"을 구원하지 않는다.
사실 더 큰 비용은 품질이다
토큰만의 문제가 아니다. 쪼개 보내면 모델은 불완전한 의도로 먼저 움직인다. 반쪽 정보로 방향을 잡았다가, 다음 조각에서 전제가 바뀌고, 되돌린다. "아니 그거 말고"가 나오는 순간, 앞서 한 작업의 일부는 버려지고 왕복이 한 번 더 늘어난다 — 그리고 그 왕복마다 위의 재계산이 또 쌓인다. 완성된 지시 하나가 주는 "전체 그림"을 모델이 처음부터 쥐고 있으면 피할 수 있었던 비용이다.
그래서 어떻게 써야 하나 — 한 번에 완성해서 말하라
보내기 전에, 머릿속에 흩어진 요청을 한 덩어리로 정리한다. 다섯 가지를 담으면 대부분 충분하다.
- 목적 — 무엇을 이루려는가.
- 맥락 — 관련 파일·증상·제약 조건.
- 기대결과 — 끝났을 때 어떤 상태여야 하는가.
- 하지 말 것 — 건드리면 안 되는 범위.
- 완료 기준 — 무엇으로 "됐다"를 판정하는가.
나쁜 예와 좋은 예를 나란히 두면 차이가 분명하다.
❌ 쪼개서:
"로그인 버그 고쳐줘" "아 세션 만료될 때" "401 계속 뜨는 거" "아니 UI 말고 미들웨어" "그리고 테스트도 돌려줘"
✅ 한 번에:
"세션이 만료되면 401이 무한 반복된다.
auth.middleware.ts에서 만료 쿠키를 감지해 재로그인 플로우로 보내도록 고쳐줘. 로그인 UI는 건드리지 말고, 수정 후 관련 테스트까지 돌려서 통과하는지 확인해줘."
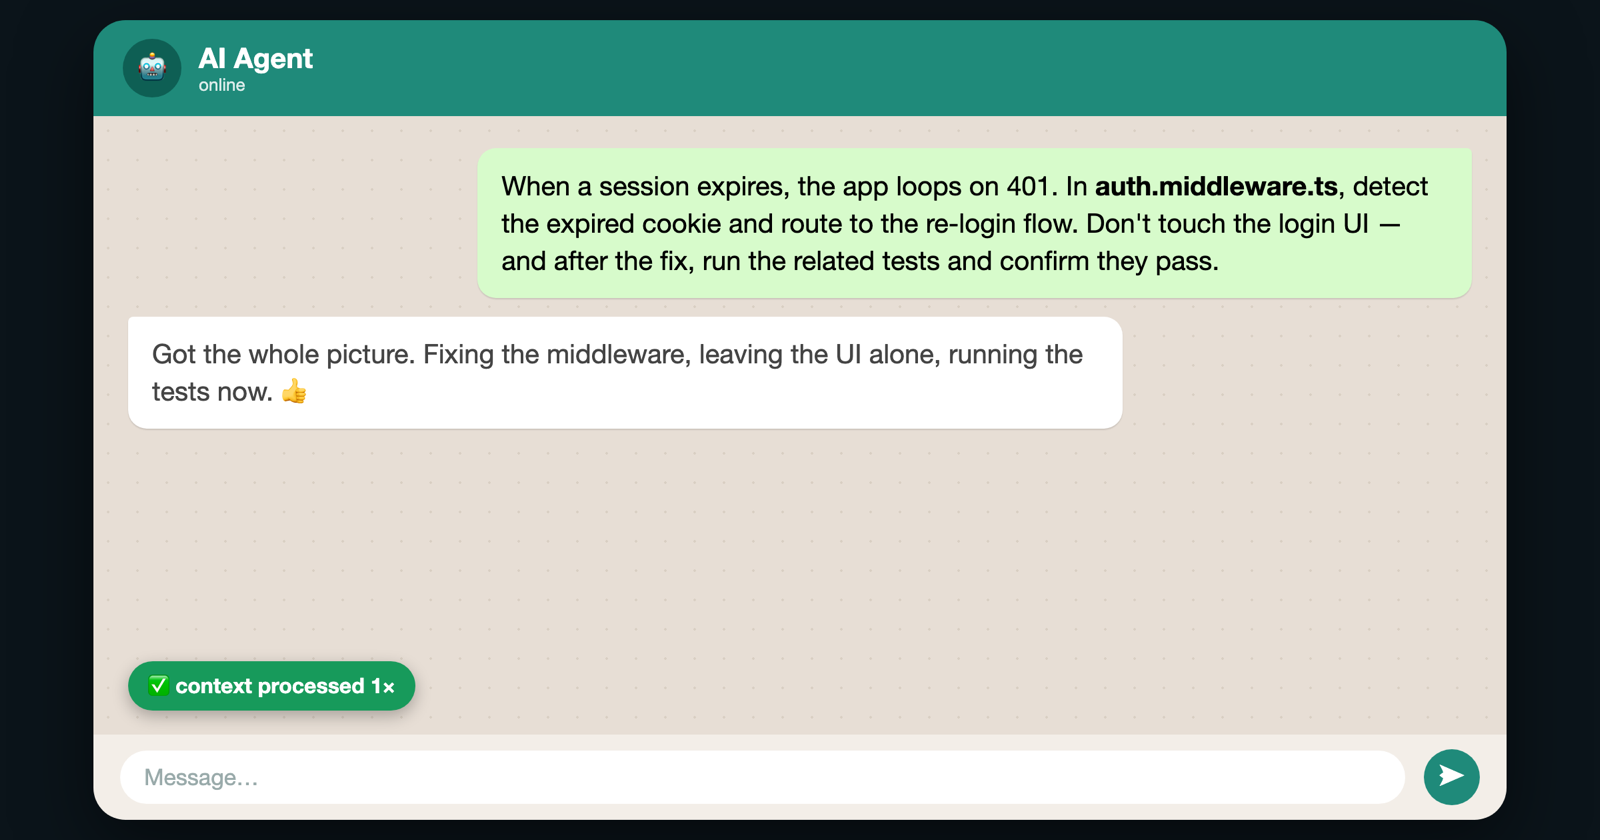
같은 분량의 정보라도, 한 메시지에 담기면 맥락은 한 번만 계산된다. 다섯 메시지로 흩어지면 그 맥락이 다섯 번 재계산되고, 응답도 다섯 번 생기고, 에이전트도 다섯 번 다시 방향을 잡는다. 입력의 총량은 비슷해 보여도, 실제로 모델이 처리하는 토큰은 전혀 다른 차원이다.
RoutineCode는 이 비용을 줄이도록 설계됐다
RoutineCode는 완성된 지시를 받으면, 그 작업을 한 번 분류해 통째로 라우팅한다 — 조각을 받아 매번 방향을 다시 잡는 대신, 전체 그림을 쥐고 시작한다. 그래서 완성해서 줄수록 이득이 커지는 구조다.
차이는 재계산되는 꼬리의 무게에서도 갈린다. "이 프로젝트가 빌드되나", "이 심볼이 어디서 쓰이나" 같은 일상 조회를, 순정 에이전트는 파일을 열어 컨텍스트에 적재하고 추론으로 답한다 — 그 파일 본문이 이후 모든 턴의 꼬리에 계속 딸려 간다. RoutineCode는 이런 조회를 추론이 아니라 결정적 도구로 처리하고 파일 본문 대신 구조화된 답만 돌려준다. 꼬리에 실리는 게 가벼우니, 설령 대화가 여러 턴으로 이어져도 매 턴 다시 계산되는 양이 원리적으로 작다. 넓은 탐색이 필요할 때는 그 비용을 격리된 서브에이전트 창으로 밀어내 메인 대화의 예산을 지킨다.
당신이 요청을 한 덩어리로 모으는 것과 RoutineCode가 꼬리를 가볍게 유지하는 것은, 같은 목적 — 매 턴 다시 계산되는 맥락을 최소로 유지하는 것 — 을 위한 두 방향의 노력이다.
기대효과와 결과
- 같은 작업에 드는 토큰이 준다. 무거운 맥락을 여러 번 재계산하지 않는다.
- 결과가 한 번에 맞는다. 모델이 전체 의도를 처음부터 쥐고 있어, "아니 그거 말고"의 왕복이 준다.
- 긴 세션에서 예산이 오래 간다. 꼬리가 가벼우면 컨텍스트 윈도가 늦게 찬다.
에이전트를 잘 쓰는 것은 결국 좋은 입력을 주는 일이다. 그리고 좋은 입력의 규칙은 두 가지다 — 요청을 좁게 겨냥하고(1편), 한 번에 완성해서 말하는 것(이 글). 메신저 습관을 작업 지시에까지 들고 올 필요는 없다.
이 글은 "LLM을 잘 쓰는 법" 시리즈의 한 편이다. 1편(정밀한 요청은 예의가 아니라 토큰 경제학이다)과 함께 읽으면, "무엇을 요청하는가"와 "어떻게 나눠 보내는가"가 각각 어떻게 토큰이 되는지 한 쌍으로 이해된다.
참고 자료
Want posts like this weekly?
Subscribe for AI dev-workflow insights.